MÉTHODE
D’abord petit et fonctionnel, ensuite on élargit.
Nos collaborations ne commencent ni par le « choix de plateforme » ni par une « stratégie IA », mais par une tâche réelle. Voici la méthode complète, ce que vous recevrez et ce que nous ne faisons pas.
PROCESSUS / QUATRE ÉTAPES
D’un échantillon réel au transfert de compétences
-
01
Prendre un échantillon réel
Choisissez une tâche fréquente, chronophage et source d’erreurs ; apportez un échantillon anonymisé et votre méthode actuelle. Définissez d’abord ce que « réussi » signifie.
-
02
Construire une validation minimale
Cartographier données, règles et limites, puis réaliser une petite version exécutable. Si la validation échoue, vous savez tôt pourquoi — et quelles sont les alternatives.
-
03
Intégrer le flux, garder les freins
Connexion à vos e-mails, tableurs, bases de données ou systèmes internes existants ; les envois sortants, les décisions à risque et les exceptions gardent validation humaine et retour arrière.
-
04
Livrer et transférer la capacité
Code source, configuration, documentation et traces de validation sont livrés. Vous pouvez maintenir vous-même, ou nous confier des itérations par phases.
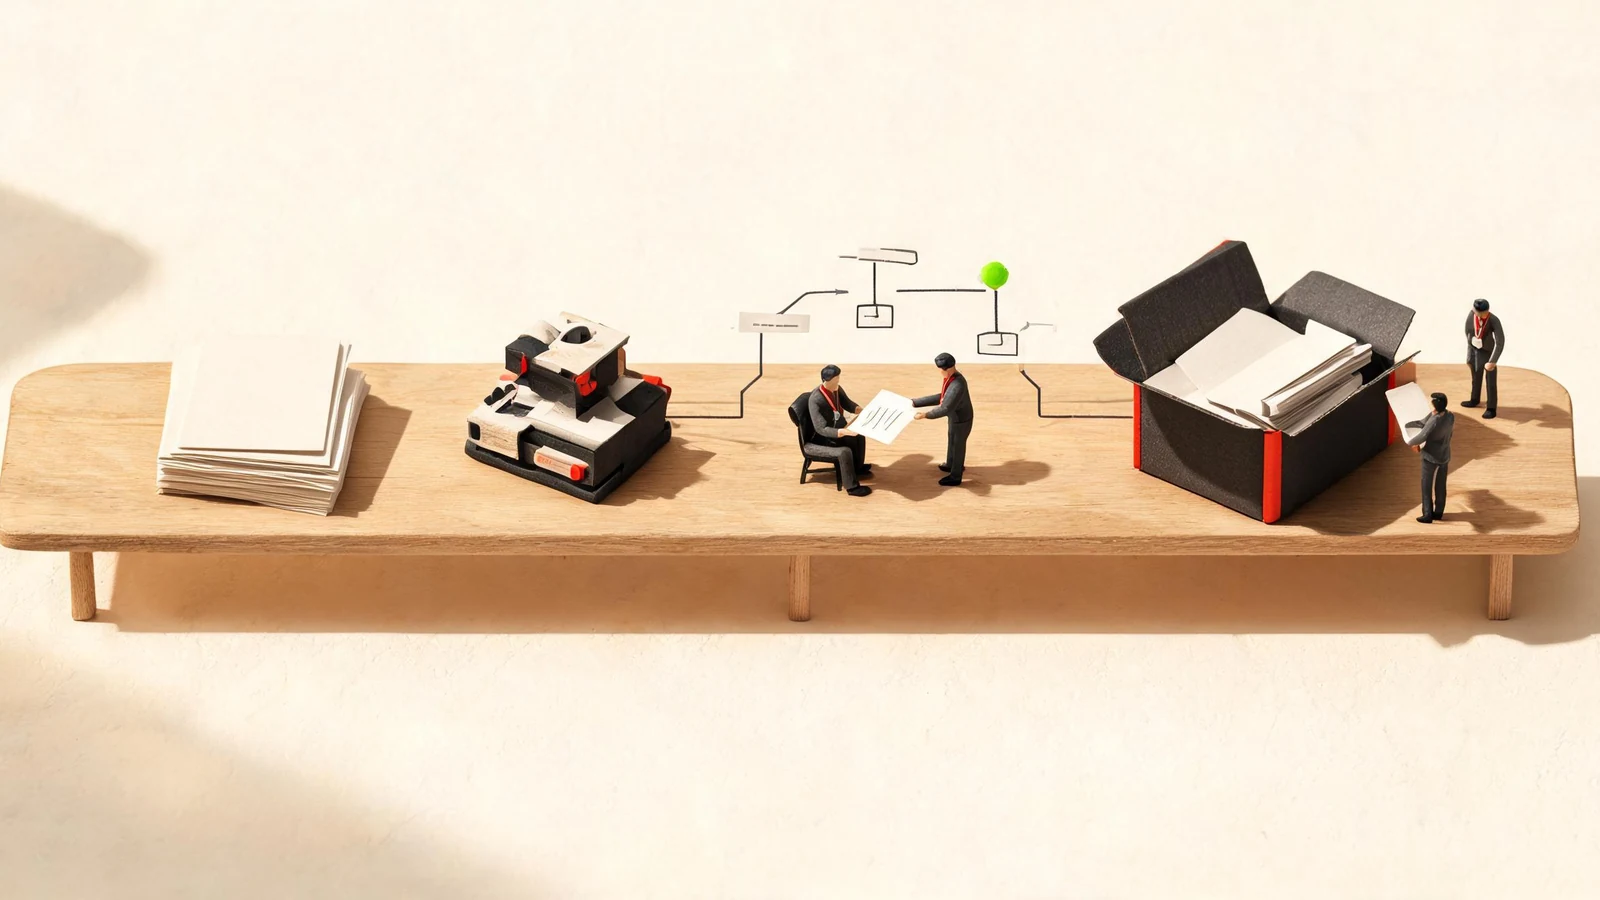
LIVRABLES
Ce que vous avez en main à la fin du projet
Aucune boîte noire : chaque livrable est inscrit au périmètre avant de commencer ; pas de systèmes fermés que seul le prestataire peut modifier.
-
01
Un système qui tourne
Une petite version qui se branche sur vos processus existants — pas des captures d’écran d’un prototype de démo.
-
02
Code source et configuration
Code source du projet et notes de configuration transmis ensemble, pour que vous puissiez modifier et maintenir vous-même.
-
03
Documentation d’utilisation
Pour que celui qui reprend sache comment l’utiliser, le modifier, et où regarder en premier quand quelque chose casse.
-
04
Traces de validation
Quels échantillons ont servi, ce qui a été validé, quels scénarios restent non couverts — tout est consigné.
LIMITES
Ce que nous ne faisons pas
Ces limites ne sont pas des restrictions : elles rendent le résultat du projet prévisible.
- Nous ne prenons pas de demandes vagues du type « construisez d’abord une grande plateforme » : nous définissons d’abord ce que « réussi » signifie.
- Les e-mails sortants, les décisions clés et les actions à risque gardent une validation humaine — pas d’exécution automatique sans surveillance.
- Les cas ne montrent que l’état réel : en fonctionnement, en ligne, interne, prototype ou en itération — étiqueté honnêtement.
- Si une chose ne se prête pas à l’IA, nous le disons directement ; nous n’empilons pas la technologie pour décrocher un projet.
FAQ
Les questions qu’on nous pose le plus souvent avant de commencer
Faut-il vraiment construire une grande plateforme de zéro ?
Non. Dans la plupart des cas, partir d’un flux réel et de vos outils existants est plus sûr. Validez d’abord la valeur, puis décidez du périmètre du système.
Peut-on ne pas dépendre d’un grand modèle unique ?
Oui. Les modèles se choisissent selon les données, le coût, le déploiement et les résultats ; pour les cas déployables en privé, le matériel et les coûts de maintenance sont évalués séparément — et tout besoin ne se prête pas à une installation locale.
Nous avons déjà des e-mails, Excel ou des systèmes internes : est-ce intégrable ?
Oui. Nous vérifions d’abord si vos systèmes offrent des interfaces, des formats de fichiers ou des accès de base utilisables. Sans interface, nous évaluons des flux semi-automatiques au lieu de forcer le tout-automatique.
Nos données seront-elles publiées ?
Les démonstrations et le développement doivent utiliser des données anonymisées. Les droits réels, le stockage et les modalités d’appel aux modèles sont confirmés par projet ; les cas de ce site ne divulguent jamais de documents clients, d’identifiants ni d’adresses internes.
À qui appartiennent le code source et la documentation ?
Le périmètre de livraison est écrit avant de commencer. Notre livraison standard comprend le code source du projet, les notes de configuration et la documentation d’utilisation — pas de système fermé « modifiable par le seul prestataire ».
Comment commencer ?
Envoyez un e-mail décrivant ce que vous faites en boucle, les outils de chaque étape et où les erreurs surviennent le plus, avec un échantillon anonymisé. Nous commençons par discuter d’une petite tâche vérifiable.
COMMENCER
Choisissez une tâche réelle ; nous définirons ensemble ce que « réussi » veut dire.
E-mail : trade@seedestiny.com.cn